AIに実装させるより、取りこぼしを拾うほうが効く — 開発ラインを8つの自動化で回した記録
2026-10-03
#AIエージェント#自動化#コードレビュー#開発プロセス#Claude Code
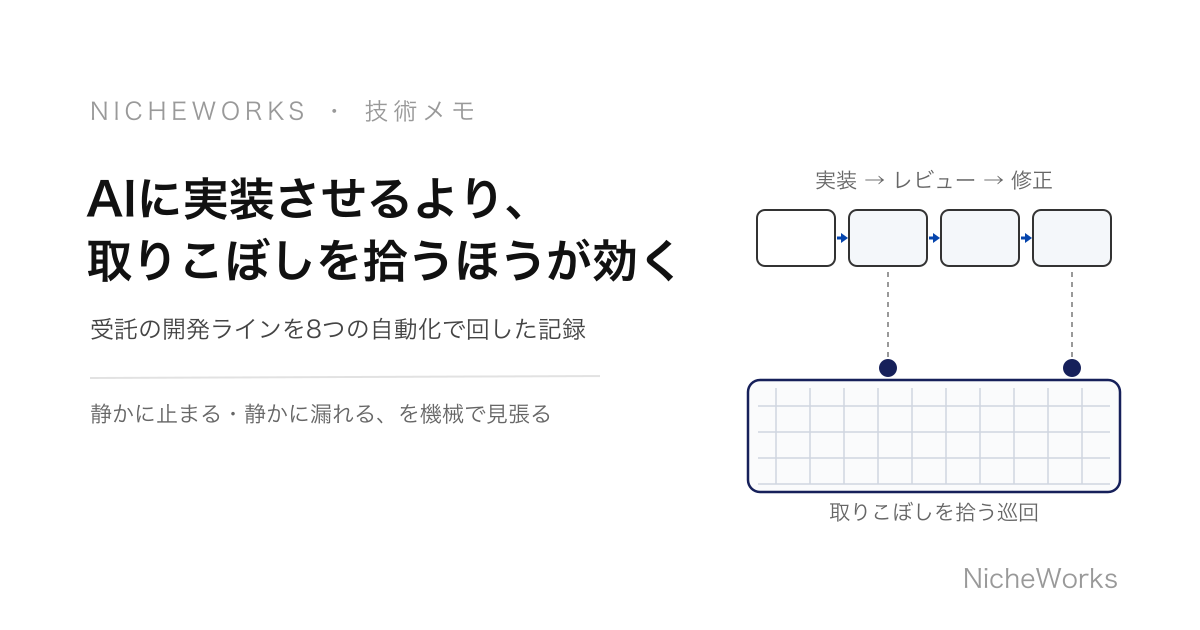
AIにコードを書かせること自体は、もう難しくない。IssueをAIに渡せばPRが上がってくる。問題はその後で、上がってきたものを誰がどう確認し、指摘された後に誰が直し、直したことをどう確かめるか——ここが人力のままだと、量が増えた瞬間に詰まる。
当社が受託開発で使っている「開発ハーネス」は、この後半部分を機械に寄せたものだ。現在8つの自動化が定期実行されているが、実装を担当しているのは1つだけで、残り7つは全部「取りこぼしを拾う」ためにある。この比率がこの記事の主題そのものだ。
以下、案件固有の情報(顧客名・リポジトリ・Issue番号)は伏せて、仕組みと設計判断だけを書く。数値・構成は2026年8月時点のもの。
要点(先に結論)
- 詰まるのは実装ではなく確認と追跡。だから自動化の比率も 実装1:追跡7 になった
- AIエージェントの失敗は派手に落ちない。静かに止まり、静かに漏れる。だから「起きたことを検知する」より「起きるべきことが起きていないのを検知する」設計が要る
- 一次ルールには必ず穴があるので、穴を埋める二次の巡回(安全網)を別ジョブとして置く
- 巡回自身も壊れるので、巡回を見張る巡回が要る
- 指摘は「直した」で終わらせず、再発したらルールに昇格させ、昇格が効いたかまで機械で検証する
- 向くのはGitHubでIssue/PRを回している現場。そうでない現場には何も刺さらない
何が動いているか
すべて launchd の定期ジョブで、平日8時〜20時のみ動く。夜間と休日に自動でPRが増えても、結局レビューするのは人間なので意味がないからだ。
| 巡回 | 間隔 | 役割 |
|---|---|---|
| 自動実装 | 30分 | 着手可ラベルのIssueを実装してPRを作る |
| レビュー巡回 | 1時間 | 自分のPRとレビュー依頼PRを、実装したのとは別のAIで厳格にレビューして指摘を投稿 |
| 再試行の消化 | 5分 | メモリ不足で見送ったレビュー対象をキューから拾って実行 |
| 停滞PRの追跡 | 30分 | 指摘されたまま動きが止まったPRを検知して修正を起動 |
| 動作確認の巡回 | 30分 | 画面に変更があるのに動作確認の証跡が無いPRを検知して確認を起動 |
| メンション対応 | 1時間 | 未対応の呼びかけを検知して返信 |
| 健全性チェック | 1時間 | 上記の巡回群が静かに壊れていないかを監視し、新規異常だけ通知 |
| 状況集約・日報 | 3時間/1日 | PR・Issue・作業状況をまとめてノートに出力 |
実装(1つ目)が生む成果物は「PR」だが、2つ目以降が生むのは「放置されていない状態」だ。後者のほうが数は多い。
なぜ「安全網」が要るのか
一次ルールは、必ず特定の条件で漏れる。実例を出す。
レビュー巡回は当初「新しいcommitが来たPRだけ再レビューする」という条件で動いていた。無駄なレビューを避ける合理的なルールに見える。ところがこの条件だと、指摘を受けたまま作業が止まったPRは永久に拾われない。commitが来ないのだから再レビューの条件を満たさず、かといって指摘は残ったまま。誰も気づかないまま放置される。
これを直す方法は2つある。一次ルールを複雑にする(例外条件を足す)か、穴を埋めるだけの別ジョブを置くか。当社は後者を選んだ。一次ルールは単純なまま残し、「指摘があるのにcommitが無い状態が続いているPR」だけを見る巡回を別に立てた。
理由は、条件を複雑にするとどの条件で漏れているかが分からなくなるからだ。安全網が発動した回数を数えれば、一次ルールがどれだけ漏らしているかがそのまま見える。分離しておくと計測できる。
同じ考え方で、画面の変更があるのに動作確認の証跡が無いPRを拾う巡回もある。これも本来は実装した側が自分でやるべきことで、やらなかった時だけ後段が拾う。
AIエージェントの失敗は静かに起きる
普通のシステム障害は「落ちる」ので気づける。AIエージェントの運用で厄介なのは、動いてはいるが仕事をしていない状態が普通にあることだ。
実際に記録した失敗を分類したところ、一番多かったのが「静かに失敗する」系だった。エラーも出さず、ログも正常に見えて、ただ対象を1件も拾っていない。この手のものは、成功/失敗を見ていても検知できない。「本来なら発動しているはずの回数」と比べないと分からない。
だから健全性チェックの巡回は、エラーを探すのではなく次のような観点で見る。
- レビューされるべきPRが、レビューされないまま一定時間が過ぎていないか
- 動作確認が必要なPRが、確認されないまま放置されていないか
- ログの更新が止まっていないか(=ジョブが動いていない)
- 修正のループが終わらずに回り続けていないか(=暴走)
そして新規の異常だけを通知する。同じ異常を毎時間通知すると、すぐに見なくなるからだ。
同時に動くものは必ず衝突する
複数の巡回が独立して動くと、当然ぶつかる。実際にあったのは、あるPRの修正作業が走っている最中に、別の巡回が同じ用途の作業枠を作り直して、動いていた作業を途中で潰したという事故だ。
原因は単純で、起動する前に「すでに同じ作業が走っていないか」を確認していなかった。今はどの巡回も、起動直前に対象の作業枠が稼働中でないかを必ず確認する設計に統一している。
地味だが、複数のAIエージェントを並行で走らせる運用では、この排他の設計が最初に必要になる。エージェントは自分以外の存在を知らないので、教えるのは外側の役目だ。
「諦める」の代わりに「後回しにする」
レビューに使うプロセスはメモリを大量に食う。並列数を固定で決め打ちすると、空きが少ない時に動かして機械全体を重くするか、逆に安全側に振りすぎて能力を余らせるかのどちらかになる。
かといって「今回は空きが無いので諦める」にすると、そのPRは次の巡回まで放置される。1時間ごとの巡回なら最大1時間、運が悪ければもっと待つ。
そこで、空きメモリを実測して、足りない分は捨てずにキューに積む形にした。積まれた分は5分ごとの別タイマーが、空きが出たときだけ少しずつ消化する。一度に消化する件数を絞っているのは、空きが出た瞬間に全部実行すると負荷が跳ねるからだ。
ポイントは、実行の直前にもう一度だけ空きを確認すること。キューから複数件を取り出して順に処理する間に、状況は変わっている。変わっていたら実行せずキューに戻す。
同じ指摘を二度されない仕組み
ここが一番効いている部分かもしれない。
レビューの指摘は、そのまま流すと毎回ゼロから同じことを言われる。そこで指摘を1件ずつ記録し、別のPRで2回以上再発したパターンだけをルールに昇格させている。昇格したものは、以後すべてのレビューが必ず見る項目になる。
同じPR内での往復は数えない。同じPRで何度も同じ指摘が出るのは「まだ直していない」だけで、パターンではないからだ。別のPRをまたいで再発した時に初めて、それは個別の不注意ではなく構造の問題になる。
さらに、昇格した対応が実際に効いているかを検証する工程を後から足した。昇格した日時より後に同じ指摘がまた記録されていたら、その対応は効いていないと判定して記録する。「ルールを追加した」で満足すると、効かないルールが積み上がって、レビューが遅くなるだけになる。
散文のルールは守られない
もう一つ、運用して分かったことがある。文章で書いたルールは、守られたり守られなかったりする。人間もそうだが、AIエージェントも同じだ。
なので、絶対に守らせたいものは機械的なガードにした。実行前に危険なコマンドを検査して、共有データベースを壊す操作を止める。あるいは、「着手します」と返答しようとしているのに実際には何も起動していない場合、その投稿自体を止める(言ったまま放置された事故があった)。
ルールをどこに置くかの判断は、おおむねこうなる。
| 種類 | 置き場所 |
|---|---|
| 破壊的・不可逆な操作 | 機械的なガード(実行前に止める) |
| 頻出する品質の指摘 | レビューのルールに昇格(毎回チェックされる) |
| 文脈判断が要るもの | ドキュメント(人が読む前提。機械化しない) |
全部を機械化しようとすると、判断が要るものまで硬直したルールになって、かえって邪魔になる。機械にできることと、人が判断すべきことの線引き自体が設計対象だ。
向くケース・向かないケース
向く:
- GitHubでIssue/PRを回していて、CIとE2Eが動く状態にある現場
- 複数の変更が並行して走り、レビュー待ちや確認待ちが溜まりがちな現場
- AIで実装量は増えたが、確認が追いつかなくなってきた現場
向かない:
- Issue/PRの運用自体が無い現場。仕組みが引っかかる取っ手が無い
- 変更の頻度が低い現場。巡回のコストが見合わない
- 「AIに全部任せたい」という期待。この仕組みは任せないための仕組みで、最終的な判断は人が持つ前提で組んである
まとめ
作ってみて分かったのは、AIコーディングで本当に手間なのは実装ではなく、実装以外の全部だということだ。レビューされたか、直されたか、確認されたか、放置されていないか。人間なら「気づく」で処理していた部分が、量が増えると気づけなくなる。
だから自動化の重心も、実装より追跡に寄った。8つのうち7つが取りこぼしを拾う仕事をしているのは、設計方針というよりやっていたら自然にそうなった結果だ。
同じ構成をそのまま他の現場に持っていけるとは思っていない。前提(GitHub運用・CI・E2E)が揃っている必要があるし、何よりどこで漏れるかは現場ごとに違う。ただ、「一次ルールの穴を安全網で埋める」「静かな失敗を、起きるべきことが起きていないかで検知する」「再発したものだけをルールに昇格させる」という考え方自体は、どこでも使えると思う。
こういう仕組みごと引き受けます
この記事の内容は、当社が受託開発の現場で実際に運用しているものです。「AIで書いたコードは増えたが、確認が追いつかない」という状態は、これから多くの現場で起きます。
外部技術部では、公開・納品前のコードを第三者として確認する「リリース前コード検品」(5万円〜)から、開発プロセスそのものの整備・技術相談まで対応しています。今の開発ラインのどこで漏れているのかを見るところからでも構いません。
