AI開発ラインを64本のPRで回して分かったこと——証跡駆動という運用
2026-10-03
#AI開発#開発プロセス#自動化#E2E#Claude Code
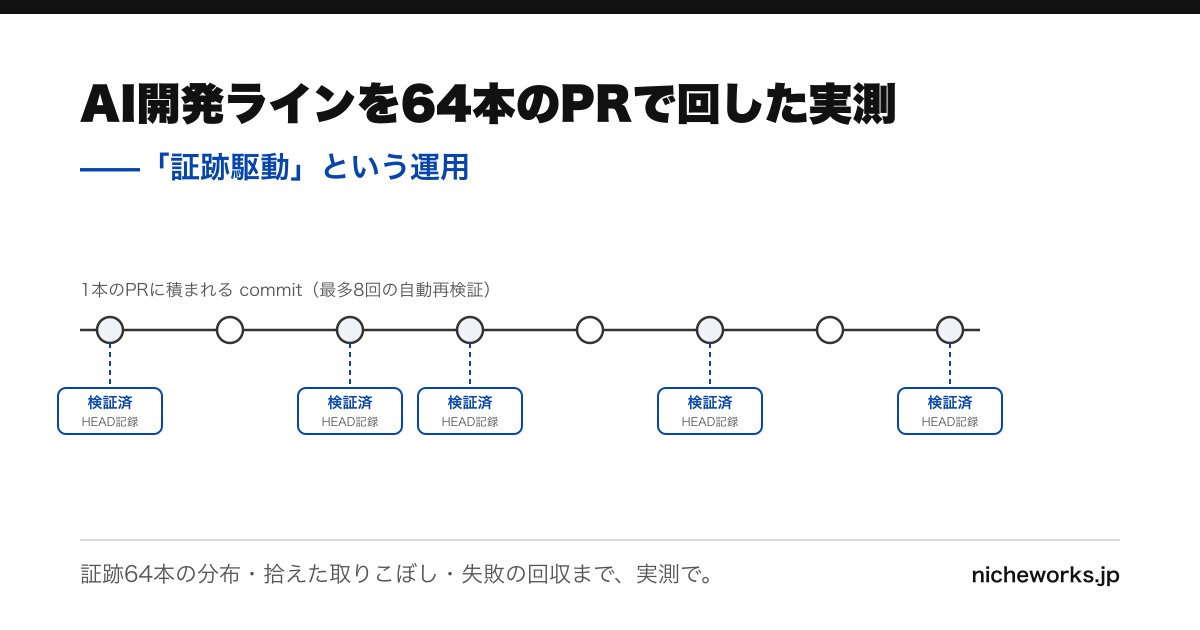
前回の記事で、AIエージェントに実装・レビュー・修正をさせる開発ラインと、その取りこぼしを拾う8つの自動化(安全網)を書いた。今回はその続編で、数ヶ月回した実測の話をする。数字はすべて実際の運用記録(2026年4月〜9月、E2E検証の証跡64本)から取っているが、対象案件が特定できる情報——プロジェクト名・画面名・業務ドメイン——はすべて伏せる。手法と数字だけを持ち帰ってもらう記事だ。
要点(先に結論)
- AIの「できました」は信用せず、「どのcommitまで、何を、いつ検証したか」の記録(証跡)を信頼の単位にした。これが今回の主題
- 証跡は64本。6割のPRは検証1回で通るが、4割はレビュー対応でcommitが積まれるたびに再検証が要る。この再検証を人手でやると破綻する。仕組みが勝手に追いかけるようにした
- 最多は1本のPRに8回の再検証。人間は8回分の結果だけ読めばいい
- 拾えた取りこぼしの例:日付依存で将来壊れるテスト(時限爆弾)を、CIが実際に落ちる前日に検出して修正
- 失敗も出た。並列レビューのメモリ不足で検証が見送られる問題は、「諦める」ではなくリトライキューに積んで空きが出たら流す設計で回収した
前回のおさらい(1段落だけ)
開発ラインの本流は「Issue → AIが実装してPR → 別のAIがレビュー → AIが修正」。この本流は放っておくと静かに失敗する——レビュー指摘が放置される、E2E1確認がスキップされる、同じ指摘が繰り返される——ので、30分〜1時間毎のパトロール群がそれを検知して拾う、という構成だった。仕組みの全体像は前作を参照。今回は「で、回した結果どうだったの」の話。
「AIのdone」を信用しない——証跡という設計
運用してすぐ分かるのは、AIエージェントの「完了しました」は検証の代わりにならないということだ。本人(AI)は本気でそう思っているが、動かして見ると画面が繋がっていないことがある。そこで、信頼の単位を「AIの申告」から「再現可能な記録」に移した。
PRごとに1枚の証跡ノートを作り、こういう形式で書かせる(内容は一般化した例):
---
pr: 1234
issue: 567 (+568, 569)
branch: feature/issue-567-list-page
---

# E2E 動作確認 - PR #1234

## 概要
一覧画面をモックから実データ駆動に置き換え。状態はサーバー側で導出する設計に変更。

## 最終検証(2026-09-01 11:16 時点・3回目)
- HEAD: `5f2ac613`(前回検証 `a6d7fbc5` から5コミット進行)
- 確認: 一覧表示 → 詳細遷移 → 登録 → 反映 の通し。リグレッションなし
- 実ブラウザでスクリーンショット取得済み
キモは HEAD2(検証時点のcommit ID)を記録すること。これで「このPRはどのcommitまで検証済みか」が機械判定できる。パトロールは30分毎に「PRの最新commit ≠ 証跡のHEAD」を見つけると、自動でE2E検証をやり直して証跡に追記する。人が「あれ、最新の修正で壊れてないよね?」と気を回す必要がなくなる。
実測1:64本の証跡と、再検証の分布
証跡は現在64本。うち49本がこの2ヶ月(8〜9月)に集中していて、ラインが本格稼働してからのペースはだいたい1営業日に1〜2本のPRが検証つきで流れる感覚になる。
面白いのは「1本のPRに何回検証が走ったか」の分布だ。
6割は1回で済む。 実装→レビュー→軽微な修正→マージ、で終わる健全なPR。一方で4割は2回以上の再検証が走っている。レビューで指摘が出て、修正commitが積まれ、そのたびに「修正で別の場所が壊れていないか」の確認が要るからだ。
最多の1件は記録上8回。レビューAIの指摘対応が同日中に何度も積まれたPRで、都度パトロールが検知して通し検証を回し、リグレッション3なしを確認し続けた。ここを人手でやると「8回、同じ画面遷移を目で確認する」作業になる。やらなくなるのが目に見えている——そして事故はその「やらなくなった回」で起きる。再検証は根性ではなく仕組みに載せるべき作業だというのが、この分布から得た一番の学びだ。
実測2:実際に拾えた取りこぼし
安全網が実際に何を拾ったか。代表例を2つ。
時限爆弾テストの事前検出。 テストコードに「特定の日付を固定で埋め込んだテスト」が紛れ込んでいた。書いた時点では通るが、その日付を過ぎた瞬間にCIが落ち始める——いわゆる時限爆弾だ。パトロールのレビューがこれを検出し、実際にCIが落ち始める前日に修正が入った。人間のレビューでこの種の欠陥を拾うのは難しい(「今は通っている」ものを疑う必要があるから)。機械的に総当たりするレビューが向いている典型例だと思う。
停滞PRの検知。 レビュー指摘を受けたまま、対応commitが積まれず止まっているPRは、「新しいcommitが来たら再レビューする」という通常ルールでは永久に拾われない。誰も悪くないのに放置が成立してしまう構造的な穴で、これは「指摘後 一定時間commitが無いPR」を探す専用のパトロールを別途用意して塞いだ。ルールの隙間は、ルールを増やすのではなく、隙間を探す係を置くほうが確実だった。
実測3:失敗も出た(そして仕組みで返した)
うまくいった話だけでは実測にならないので、失敗も書く。
並列レビューがメモリ不足で見送られる問題。 レビューAIを並列で走らせると、ローカルマシンのメモリが足りず、一部のPRの検証が見送られることがあった。最初は「そのうち次の巡回で拾われるだろう」と楽観していたが、優先順位の関係で同じPRが何度も見送られ続けるケースが出た。対応は、見送ったPRをリトライキューに積み、5分毎に「空きが出た分だけ」流す仕組みへの変更。前作で書いた「諦めるの代わりに後回しにする」原則を、リソース制約にもそのまま適用した形だ。
もうひとつ、地味だが効いたのが稼働時間ガード。自動化群は平日8時〜20時しか動かないようにしてある。夜中に無人でエージェントが暴れて、朝起きたら大量の壊れたPRが積まれている——という事故を構造的に防ぐためで、「自動化を止まれるようにしておく」のは増やすのと同じくらい重要だった。
なぜ「証跡」がこんなに効くのか
運用してみて、証跡駆動の効果は検証そのものより周辺に出た。
- 人間のレビュー時間が読める。 証跡を先に読めば「何が確認済みで、何が未確認か」が一目で分かる。PRの差分を全部追う必要がなくなり、人間は判断だけに時間を使える
- 後から監査できる。 「この機能、リリース前に本当に確認したっけ?」に、記憶ではなく記録で答えられる。受託開発では、これはそのまま納品物の品質説明になる
- AIへの指示が安定する。 「検証したら証跡に追記」という機械的なルールは、AIが一番忠実に守れるタイプの指示で、散文の注意書き(「ちゃんと確認してね」)より圧倒的に守られる
向くケース・向かないケース
向いている
- PRの流量が多く、人間のレビューがボトルネックになっているチーム
- 「AIに書かせたコードの品質をどう担保するか」に答えが要る受託・請負の開発
- 画面の通し確認(E2E)が重要なWebアプリケーション
向いていない
- PRが週に数本以下の規模(証跡運用のオーバーヘッドが割に合わない。普通に目視でいい)
- 実行環境をローカルに用意できないシステム(E2Eパトロールの前提が崩れる)
- 「AIに全部任せて人間は見ない」を期待している場合(この仕組みは人間の最終判断を安くするもので、無くすものではない)
まとめ
- AIエージェント開発ラインの信頼の単位は「AIの申告」ではなく「HEADつきの検証記録」に置く。機械が差分を検知して勝手に再検証を積む
- 実測では、4割のPRで2回以上の再検証が必要だった。ここを根性に頼ると必ず事故る
- 安全網は、時限爆弾テストの事前検出や停滞PRの回収のような「人間が拾いにくい取りこぼし」を実際に拾った
- 失敗(メモリ不足の見送り)も、諦めずにキュー化して仕組みで回収する
数値・事例はすべて自社の運用記録(2026年4月〜9月・証跡64本)に基づく。特定の製品や規模に依存する話ではないので、PR流量の多いチームならそのまま持ち帰れるはずだ。
こういう仕組みごと引き受けます
うちはこの開発ラインを実際に受託の現場で回している。「AIで開発を速くしたいが、品質の担保方法がわからない」という相談は、まさにこの証跡駆動の仕組みごと持ち込める領域なので、興味があればお問い合わせから。
Footnotes
